“不存在什么编码智能。不存在什么空间智能。不存在什么视觉智能。只有智能本身。”
Luma AI联合创始人兼CEO Amit Jain在9月末的一场访谈中,把炮口对准了行业最热的招牌“空间智能”。他补了一刀:“AI可以从60个不同角度观看一个杯子,但仍然不会告诉你,当你松手之后会发生什么。”
“There is no coding intelligence. There is no spatial intelligence. There is no visual intelligence. There’s just intelligence.” —— Amit Jain
这句话,戳破了当前AI最大的幻觉:它越来越擅长“看见”,却未必理解世界如何演化。对机器人来说,这尤其致命。它不能只识别物体,还必须在动作发生前,预判后果。
这正是世界模型要解决的问题。
一、虚拟预演沙盘
世界模型是什么?简单说,它是智能体对所处环境演化规律的抽象建模系统。输入当前时刻的完整环境状态,加上智能体即将执行的动作,它就能预测出动作执行后下一时刻的环境状态变化。对机器人而言,世界模型就是一个可快速推演的“虚拟预演沙盘”。
为什么需要它?基于真机数据的训练,硬件损耗大、周期漫长,还难以覆盖危险操作、极端工况等特殊场景。引入世界模型后,机器人无需在真实世界反复试错,就能在模型内部预判不同动作的环境反馈,筛选最优路径。这从根源上降低了部署成本,也大幅提升了复杂场景下的泛化能力。
二、拥挤的视觉通道
目前已经落地的机器人世界模型,几乎都长着同一双“眼睛”。海外有DeepMind的Dreamer系列、特斯拉为Optimus配套的端到端视觉预测世界模型、OpenAI Sora衍生模型、Meta的V-JEPA2,以及NVIDIA的Cosmos世界基础模型。国内则有字节跳动GR-2、智元机器人GE系列动作世界模型等。
技术路线各异——有的逐像素生成未来画面,有的直接在抽象表征空间中预测状态演化——但无论输入还是输出,几乎都封闭在视觉通道内。视觉世界模型是当前应用最广的路线,也是包括World Labs在内的很多团队持续投入并取得重要进展的基础方向。
但只有视觉,够吗?纯视觉模态的世界模型,本质上是对真实世界的片面建模。视觉信息只能捕捉物体的外观形态,无法承载接触力、触觉反馈、材质摩擦力、物体重量等核心物理属性。而这些物理交互信息,恰恰是决定机器人接触类操作成败的关键。
三、云道智能的答案:“给力”
给力,这不是一句口号。云道智能坚持多模态世界模型路线,把力觉、触觉、动力学参数等物理信息,与视觉信息一起纳入核心建模维度,完整还原真实世界的物理演化规律,支撑机器人完成精细复杂操作。
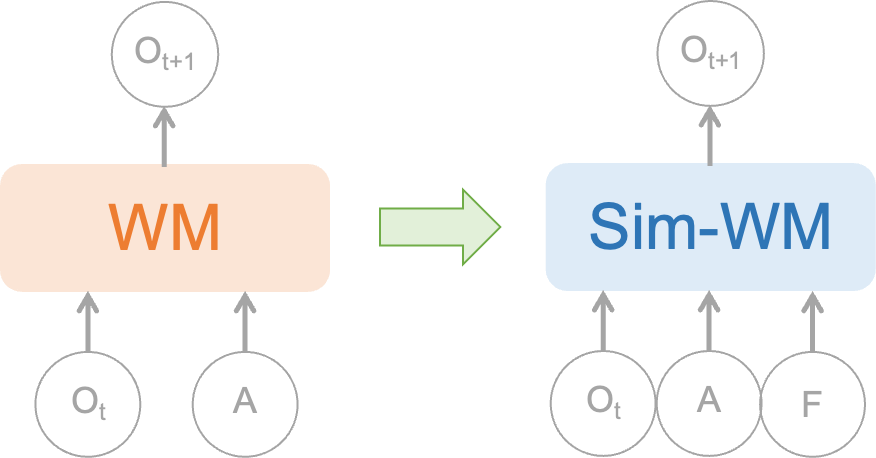
扎根物理引擎,云道智能基于物理AI开发平台训练出多模态世界模型Sim-WM。从Simdroid到Sim-PI,再到Sim-WM,这不是追热点的新故事,而是仿真积累的自然延伸。
与只“吃”图像的纯视觉世界模型不同,Sim-WM将受力通道显式纳入建模:以当前时刻的视觉观测Ot、夹爪/关节受力信息F以及即将执行的动作A作为输入,预测下一时刻Ot+1的视觉观测。其中视觉观测并不在像素空间直接做逐步生成,而是先经编码器映射到潜空间,再在特征层面完成动作条件下的状态转移预测,从而在保证表达能力的同时显著提升多步推演效率。
四、力,让预测更准
为什么加一个“力”,预测就能更准?
夹取是典型的接触密集操作。力度与接触状态会直接改变物体位姿与后续视觉外观。缺少受力通道时,模型只能从像素变化中间接猜测接触,既吃力也容易过拟合外观。
而在仿真中,受力标签几乎零成本可得。高保真物理引擎天然就会实时计算环境中所有物体的受力状态、碰撞反馈、动力学参数,不需要额外加装任何传感器就能直接输出完整的物理交互模态信息。把受力写进世界模型,是让预测“更强、更稳、更可规划”的关键一步。
多模态世界模型的训练离不开仿真。公开数据集几乎全是视觉视频流;真实世界采集力觉、触觉数据,需配备昂贵易损的六维力传感器和触觉阵列,成本不可承受,也难以覆盖长尾场景。物理仿真则是唯一可行来源,能近乎零成本批量生成全品类、全类型交互样本,包括打滑、形变、碎裂等实采无法覆盖的长尾数据。仿真不是可选项,而是先决条件。离开仿真,多模态世界模型根本无从训练。
五、完整工具链:从仿真到训练
云道智能已经搭建了一套完整的工具链:底层由高保真多物理场耦合仿真驱动,并覆盖数据生成、模型训练和模型验证等核心能力,为具身模型落地提供全方位支撑。
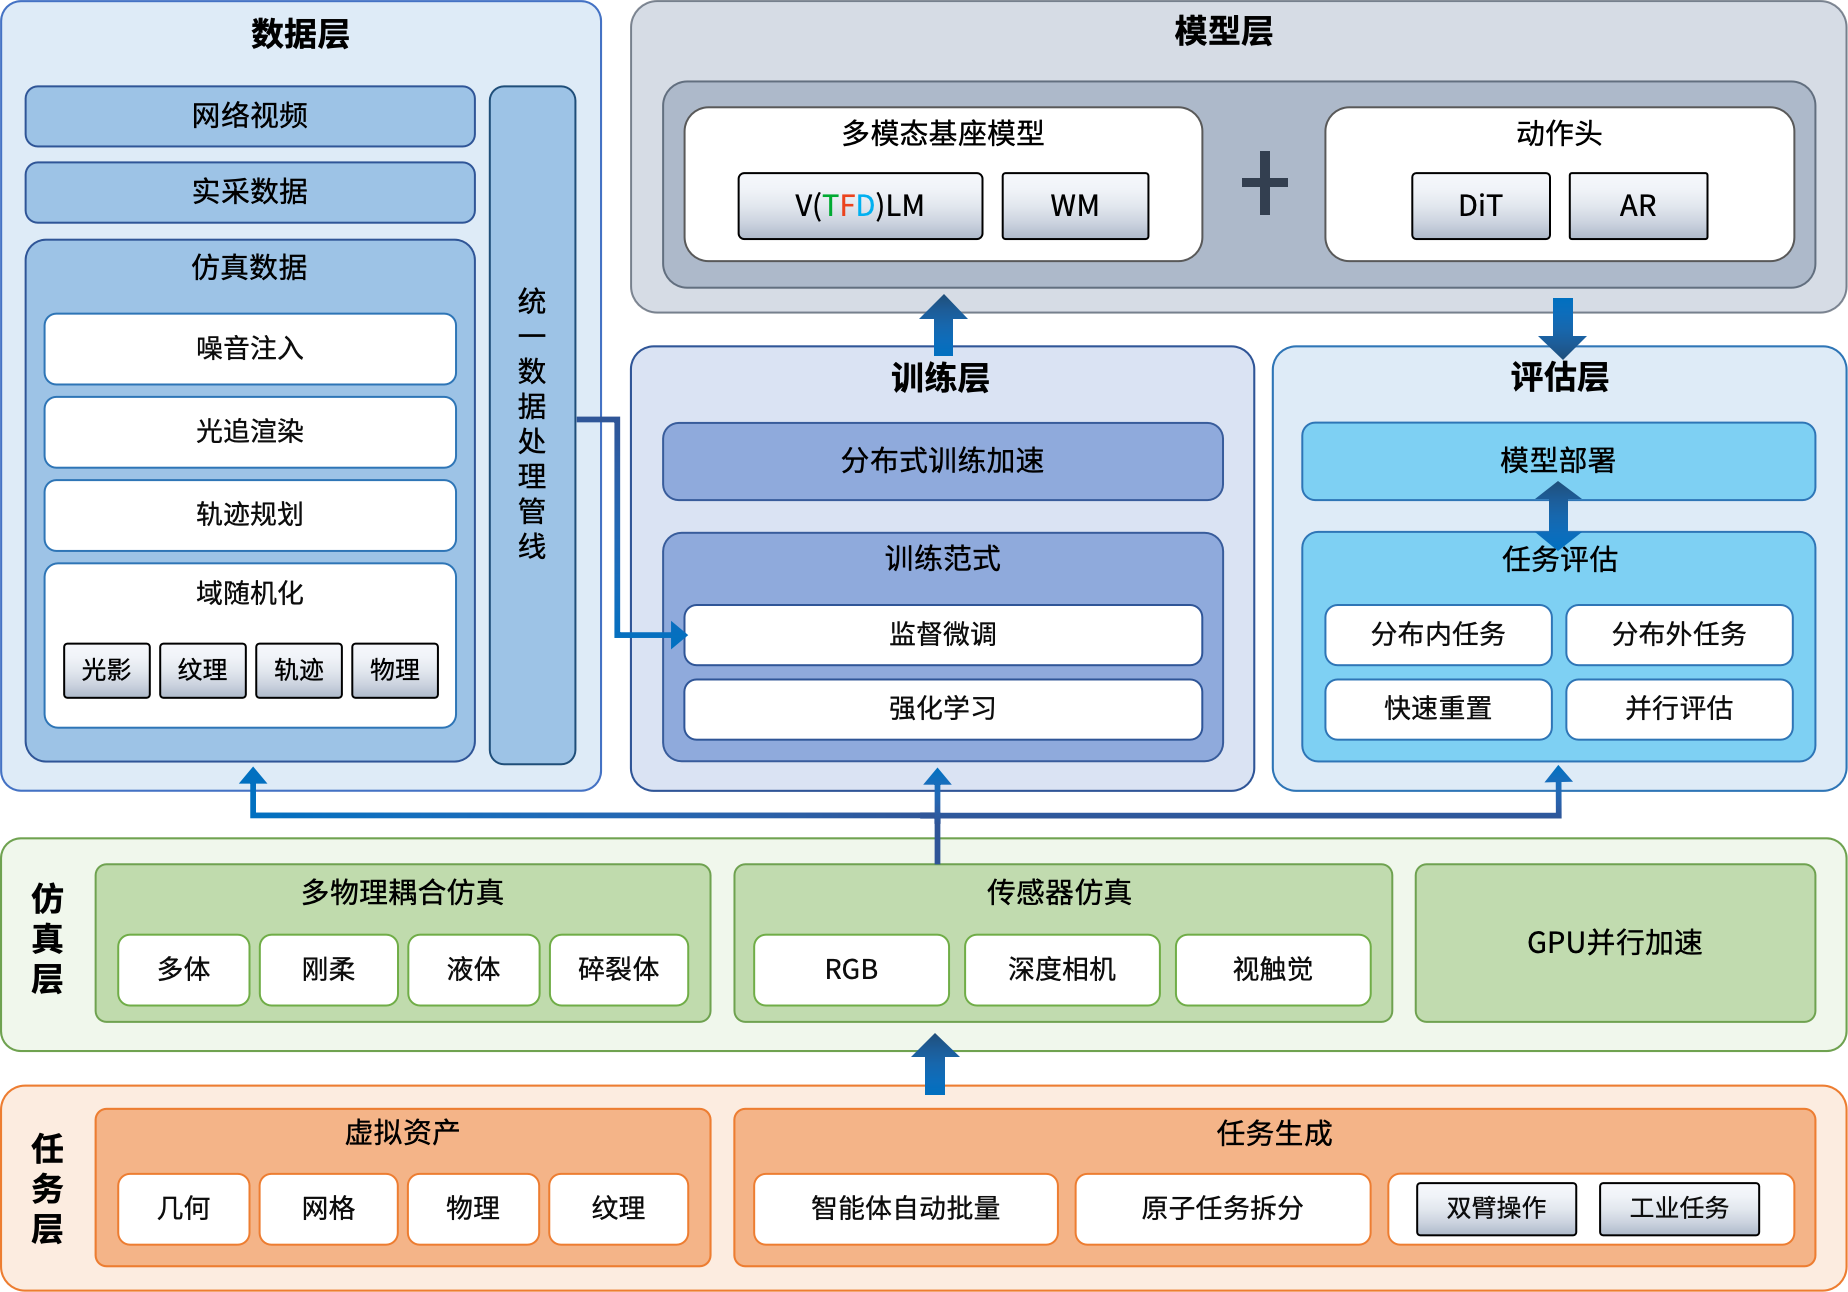
任务层通过仿真生成多样化场景,重点覆盖长尾场景;支持单条实采数据扩展为大规模仿真数据,并一键完成光影、纹理、轨迹、物理等域随机化。训练层覆盖监督微调与强化学习:前者基于大规模多模态数据对基座模型进行预训练与微调;后者以仿真环境为可交互训练环境,让模型在交互中持续优化策略。评估层则驱动模型迭代——真实部署评测危险昂贵,仿真评测快且安全。
六、小切口,真验证
在上述工具链支撑下,云道智能训练出多模态世界模型Sim-WM v0.1。
它聚焦单机械臂、单任务的“小切口”场景。训练数据全部来自Sim-PI的仿真与数据生成模块,涵盖多视角视觉信息与机械臂夹爪受力序列。除成功示教轨迹外,还混入带随机扰动的派生轨迹,以学习可外推的潜空间动力学,而非记忆少数成功样例。经52000步训练后,模型逐步收敛,能够在潜空间中稳定完成动作条件下的多步预测,且解码结果与真机/仿真回放在运动趋势和接触时序上保持一致。
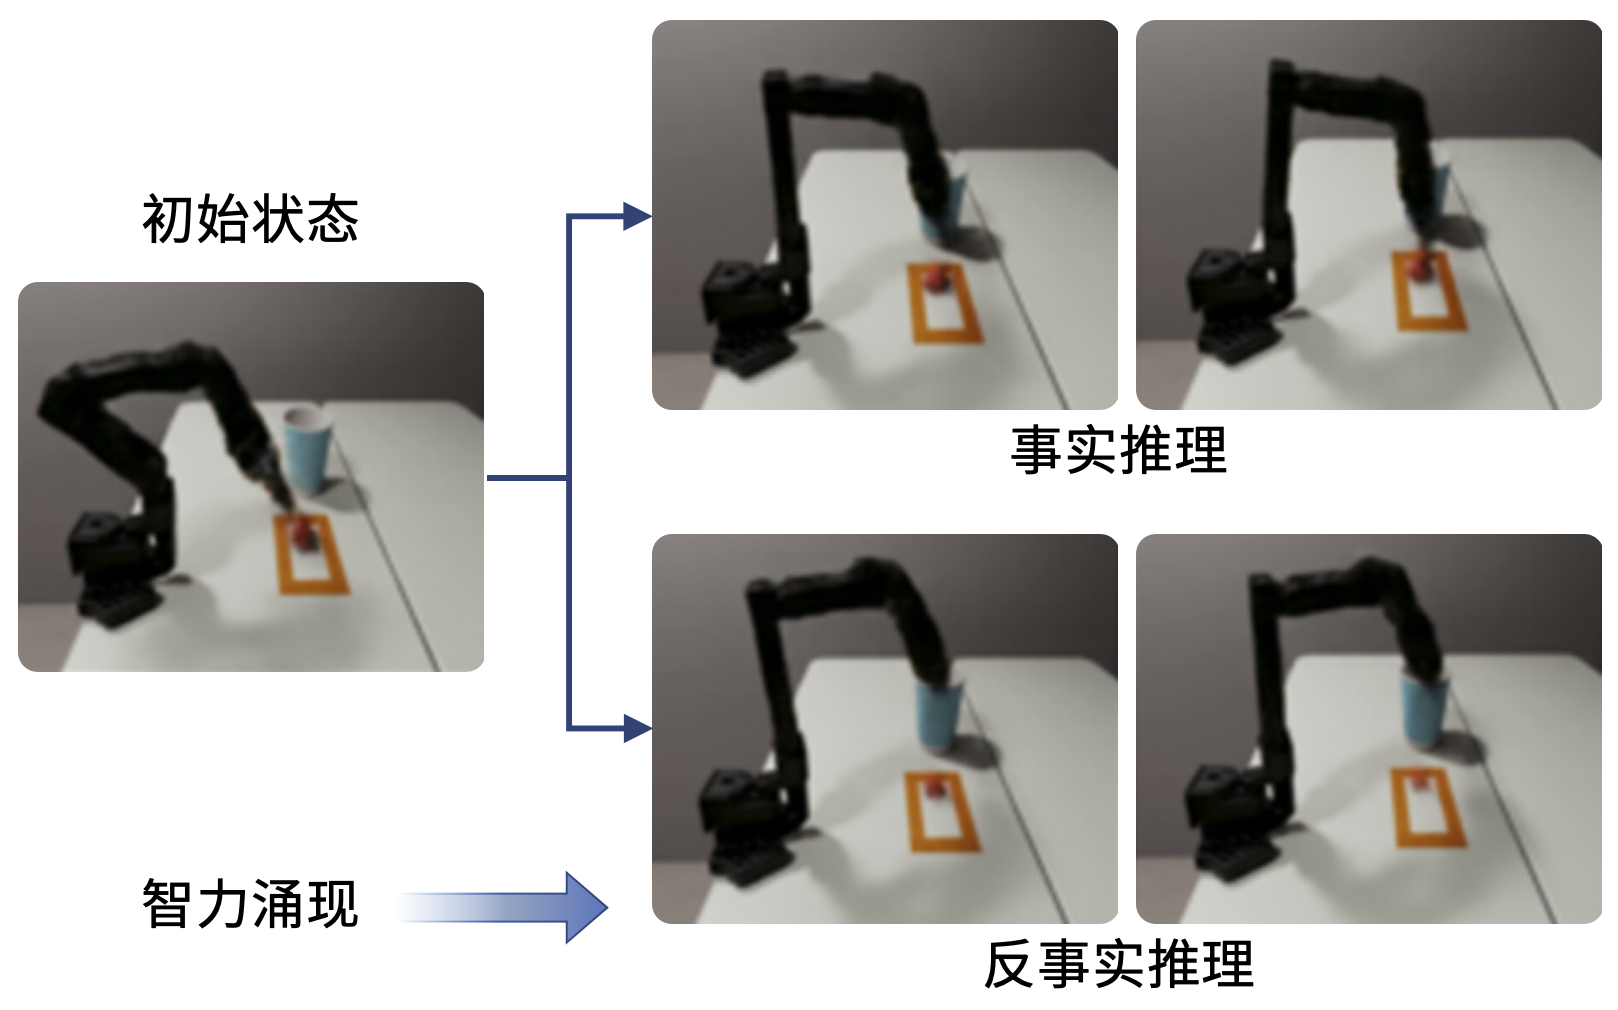
更重要的是,收敛后的Sim-WM并非只会“续播”一段固定视频,而是展现出可验证的反事实推理能力。保持同一初始观测不变,仅改写动作序列,再让预测器向前滚动想象:输入参考抓取轨迹时,模型预测机械臂按预期接近并完成接触;将参考轨迹整体抬高后,接触与抓取进程随之改变。这些分支在物理直觉上可区分、在视觉结果上可对照,说明模型学到的是“动作如何改变未来”的可干预动力学。
七、从看见,到理解力
当世界模型能在潜空间中预演“动作如何改变未来”,它的意义就超出了实验室抓取。具身智能进入工业产线、精密装配和危险作业后,机器人面对的多是接触密集、力控敏感的场景。纯视觉世界模型只能告诉机器人“看起来会发生什么”,难以回答“用力之后会发生什么”。
多模态世界模型补的正是这一维。云道智能的关键,不是让机器人“看见”世界,而是把“力”写进模型,让它在虚拟预演中感知力、理解力、运用力。从纯视觉到多模态,Sim-WM正为具身智能补上通往真实世界的关键一维。